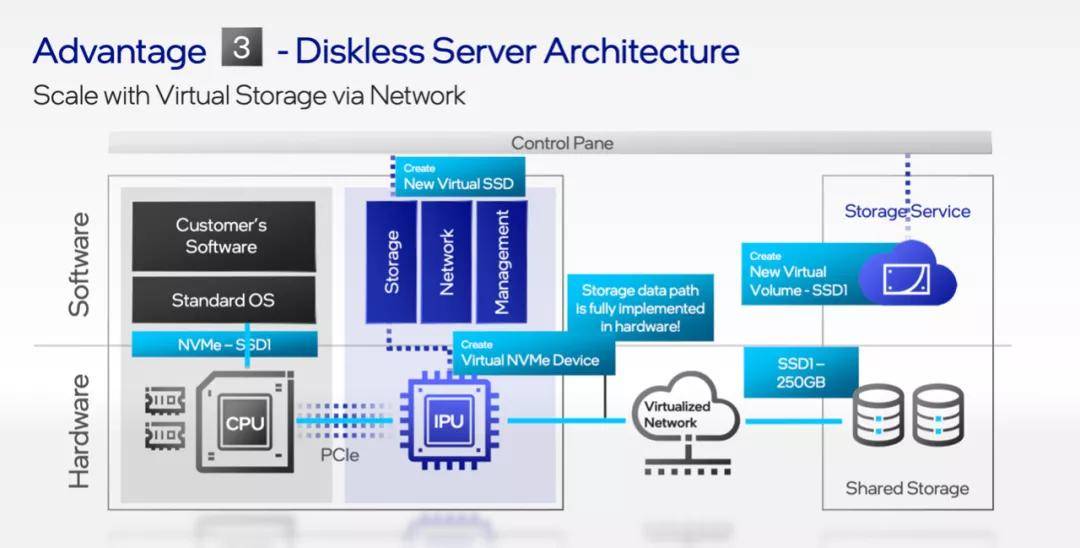
在現(xiàn)代大數(shù)據(jù)架構中,隨著數(shù)據(jù)量的爆炸式增長、云原生與容器化技術的普及,傳統(tǒng)Hadoop“存算緊耦合”模式越來越難以滿足彈性、效率與成本控制的需求。華為云、阿里云、AWS等相繼推出存算分離解決方案,正是因為它打破了計算與存儲的容量耦合限制。本文詳解Hadoop存算分離的前世今生,以及其在云原生背景下如何重塑數(shù)據(jù)處理與存儲服務。\n\n## 一、為什么存算必須分離——從緊耦到松耦演進\n傳統(tǒng)Hadoop集群(HDFS+MapReduce/YARN)之所以將DataNode與NodeManager部署在同一批機器上,是為了數(shù)據(jù)本地性的超高效率——計算直接把服務放到所在數(shù)據(jù)節(jié)點的本地磁盤上進行讀取。但當我們需要運行spark job數(shù)量增加+集群需要擴展到數(shù)千節(jié)點,問題涌現(xiàn)如下:\n- 存儲—計算按同一比例機器擴展,閑置即資源浪費。比如相同業(yè)務冷計算需要54 GB/內核和147 GB內存或大量IO,就必須拖動本就過剩的硬盤。\n- 上游寫入即可同步產(chǎn)生副本帶來I/O放大了兩倍,拉滿磁盤控制極端災難。整體成本高出云存儲一個階段倍數(shù)。\n因此松動分離的設計應需強調幾個基本轉型,成為了此次換代。“存算分離”還有“純數(shù)據(jù)導出計算未拿到數(shù)據(jù)的結果體需求不一致‘別慌’機制,‘數(shù)吃算’,但杜絕鏈路重復多次落盤,到代碼快速拉近數(shù)據(jù)能力通過 S3A/OZONE/SPARK內存優(yōu)化多種路徑嘗試。”分開來看\n\n既有意圖符合“穩(wěn)定不如瞬、池靈活擴容”“成本受資源配置彈性限制的轉之生路更是戰(zhàn)略引擎服務設計”等課題要求標準正是——基于對象服務整合等支撐跨時代大系統(tǒng)現(xiàn)代化重構需求工程算數(shù)引擎帶來穩(wěn)定線寬作為驗證標準,我們繼續(xù)深層細入幾小節(jié)擴展每條構成為\n\n...\n\n我們將沿著變革關鍵路線排布結構詳細介紹——\
Hadoop存算分離 云原生數(shù)據(jù)存儲管理與處理的新范式
更新時間:2026-09-05 04:47:43
如若轉載,請注明出處:http://www.dadibbeidaiy.cn/product/112.html
PRODUCT
產(chǎn)品列表